강의 자료 PDF를 클로드에게 읽히다가 방법을 바꿨습니다.
파일을 그대로 첨부하지 않고, 컴퓨터에서 글자만 뽑은 마크다운 파일로 바꿔 읽게 했습니다.
이유는 토큰이었습니다.
PDF나 엑셀 파일을 그대로 주면 토큰을 많이 쓰고, 내용이 정확하게 전달되지 않을 수도 있다고 생각했습니다.
토큰은 AI가 글을 읽고 쓸 때 세는 단위입니다.
구독 요금제에도 쓸 수 있는 양이 정해져 있어서, 같은 자료를 적은 토큰으로 읽히면 그만큼 더 쓸 수 있습니다.
그 과정에서 MCP라는 것을 처음 연결해 보았습니다.
MCP는 클로드에 도구를 붙여 주는 연결 방식입니다.
이번에 붙인 도구는 마이크로소프트가 공개한 문서 변환기 MarkItDown입니다.
MCP로 붙인 이유도 같습니다.
변환기를 클로드에 연결해 두면 제가 파일 위치만 알려 줘도 클로드가 직접 마크다운으로 바꿔 읽습니다.
제가 따로 변환 프로그램을 열지 않아도 됩니다.
한 줄로 시킨 MCP 연결
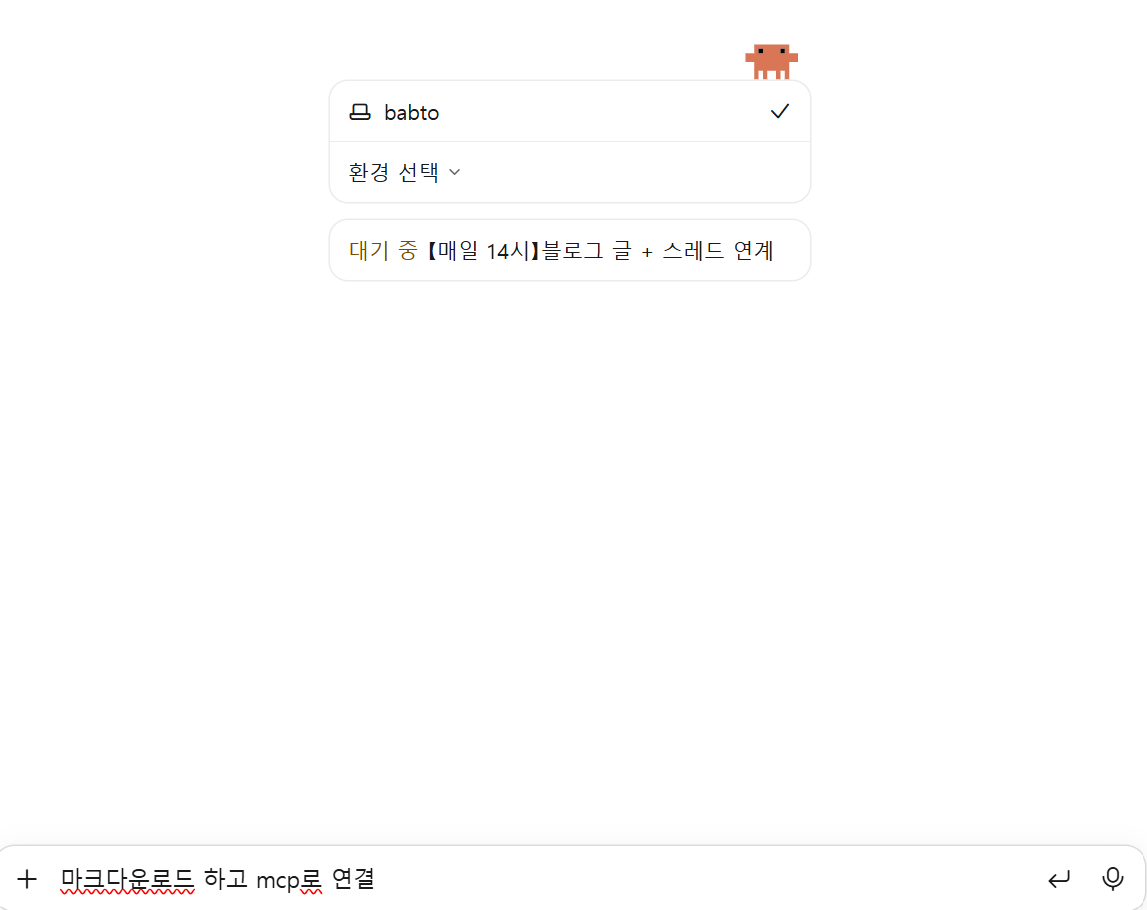
제가 클로드 코드에 입력한 것은 "마크다운로드 하고 mcp로 연결"이라는 한 줄이었습니다.
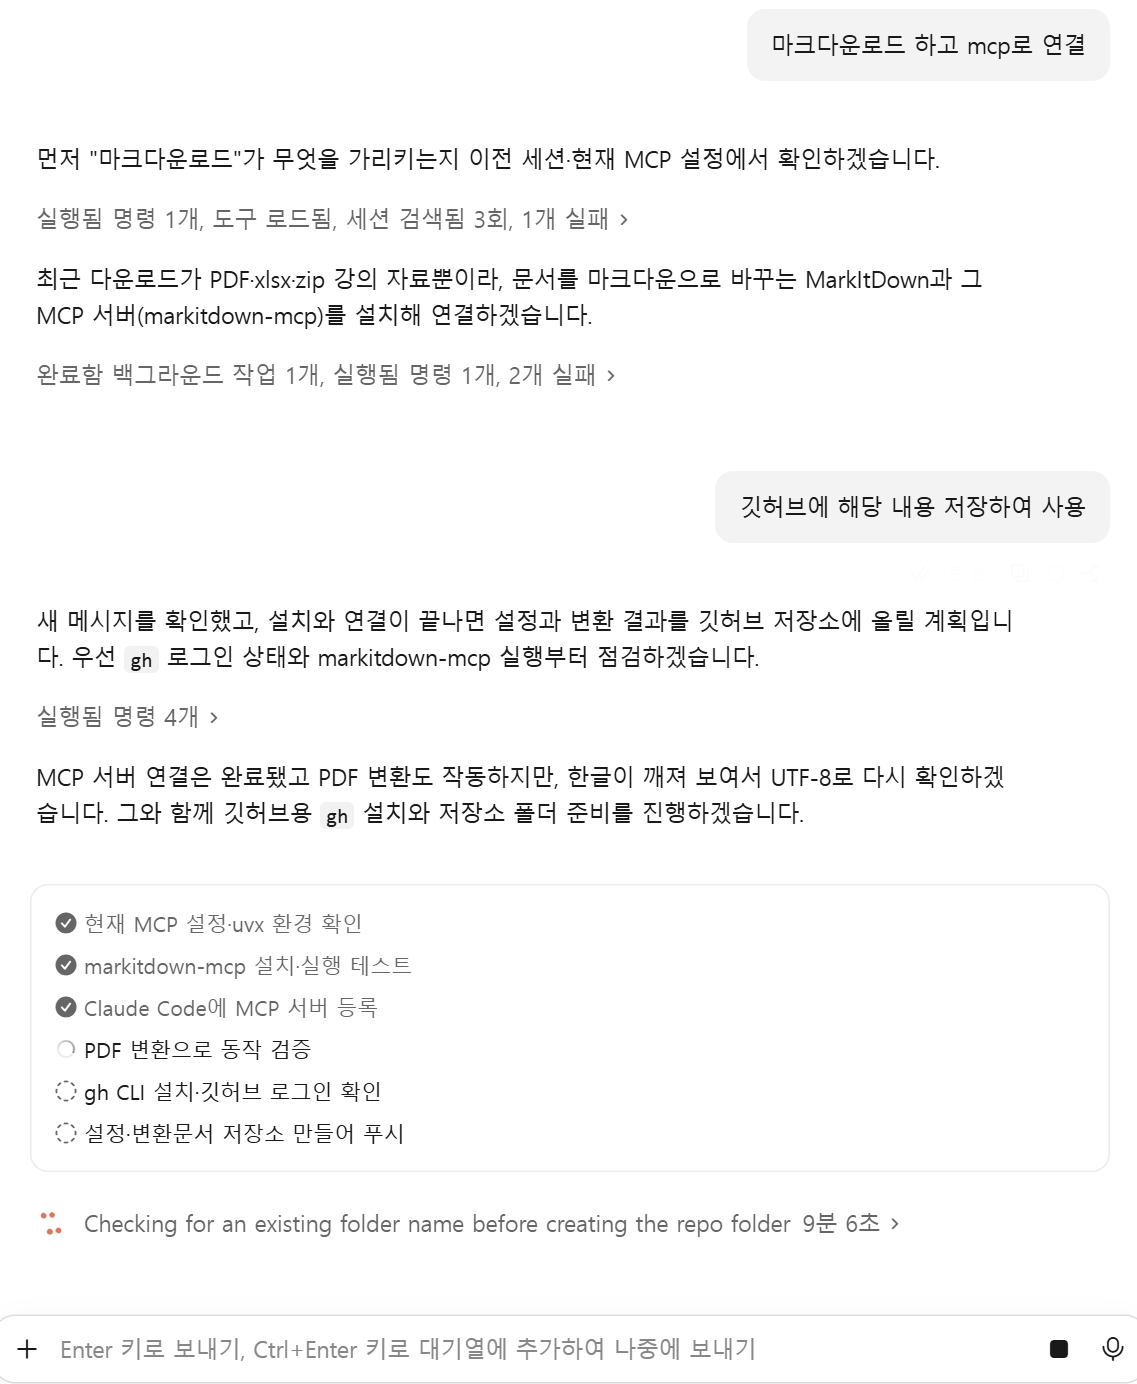
마크다운을 잘못 친 말이었는데, 클로드는 무엇을 가리키는지 먼저 확인한 뒤 변환기와 MCP 서버를 설치했습니다.
연결은 아래 명령으로 끝났습니다. 등록한 뒤 상태를 확인하면 Connected로 나옵니다.
claude mcp add --scope user markitdown -- uvx markitdown-mcp
claude mcp get markitdown
중간에 막힌 곳도 있었습니다. 변환은 되는데 한글이 깨져 나와서, 파이썬이 UTF-8로 읽도록 설정을 하나 더 넣었습니다.
깃허브를 거쳐 읽는 줄 알았습니다
변환한 파일은 깃허브에도 올려 두라고 했습니다. 깃허브는 파일을 온라인에 보관하는 곳이고, 로그인은 제가 직접 승인했습니다.

그래서 앞으로는 클로드가 깃허브에서 파일을 꺼내 읽는 줄 알았습니다. 확인하려고 제 생각이 맞는지 다시 물었습니다.
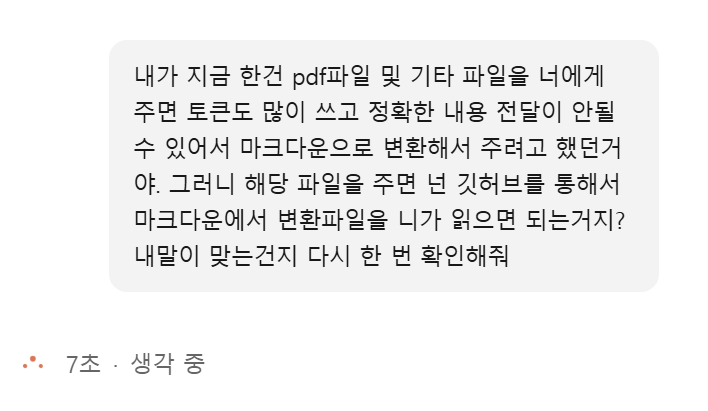
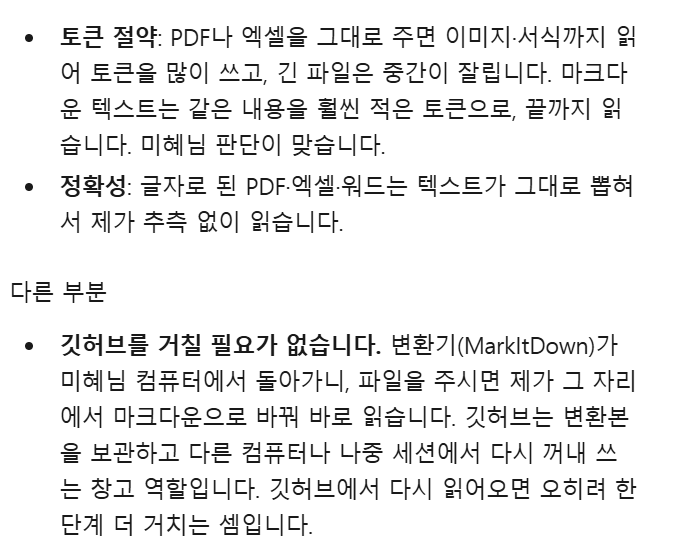
답은 반만 맞았습니다. 토큰을 아끼고 정확하게 읽는다는 목적은 맞았지만, 깃허브를 거칠 필요는 없다고 했습니다. 변환기가 제 컴퓨터에서 돌아가니 파일을 주면 그 자리에서 바꿔 읽고, 깃허브는 보관 창고라는 설명이었습니다.
크기를 비교해 보니 차이가 컸습니다.
24.6MB였던 강의 교안 PDF는 78KB 마크다운이 되었고, 16.1MB였던 전자책 PDF는 135KB가 되었습니다.
그림과 서식이 빠지고 글자만 남기 때문입니다.
토큰도 재 보았습니다.
17쪽짜리 교안을 바꾼 마크다운 파일은 클로드에게 읽혔을 때 약 7,100토큰이 들었습니다.
17쪽 전체를 읽는 데 든 양입니다.
PDF를 그대로 주면 클로드는 한 쪽을 글자와 이미지로 함께 읽습니다.
클로드 공식 문서에 따르면 글자가 있는 쪽은 글자에만 쪽당 1,500~3,000토큰이 들고, 여기에 쪽마다 이미지 토큰이 더해집니다.
PDF도 직접 재 보려 했지만 읽히는 방식에 따라 숫자가 크게 달라서 공식 기준으로 적었습니다.
그 기준으로만 봐도 마크다운 17쪽 전체가 글자 PDF 2~5쪽 분량입니다.
글자 없는 PDF는 빈 파일이 나왔습니다
모든 PDF가 바로 바뀌지는 않았습니다.
강의 교안은 쪽마다 글자가 아니라 그림으로 들어 있는 PDF라서, 변환기를 돌리면 빈 파일이 나왔습니다.
이런 파일은 윈도우의 한국어 글자 인식(OCR)으로 그림 속 글자를 읽어 바꿨습니다.
내 PDF가 어느 쪽인지는 PDF를 열고 글자를 마우스로 끌어 보면 알 수 있습니다.
글자가 선택되면 바로 변환되고, 선택되지 않으면 글자 인식이 필요합니다.